在2018世界机器人大会17日的主论坛上,中国电子学会发布《新一代人工智能领域十大最具成长性技术展望(2018-2019年)》。
当前,全球正在经历科技和产业高度耦合、深度迭加的新一轮变革,大数据的形成、理论算法的革新、计算能力的提升及网络设施的演进驱动人工智能进入新一轮创新发展高峰期,新技术持续获得突破性进展,呈现出深度学习、跨界融合、人机协同、群智开放、自主操控等以应用为导向的新特征。加强新一代人工智能技术的前瞻预判,准确把握全球技术创新动态及发展趋势,将为行业健康发展、资金有序进入、政策规划出台、新兴市场开拓等提供具备决策参考价值和实践指导意义的智力支撑。
近年来,物联网、云计算、大数据、人工智能等专业名词愈来愈成为信息产业和科学技术界的热门词汇,这四者紧紧相连、密切相关、不可分割。
<strong>物联网</strong>
<font size="3"><strong>背景介绍</strong></font>
这些年,物联网的快速发展,也令连网设备的数量与日俱增。然而,有网络的地方就会有安全问题,根据安全研究员曝光的数据显示,物联网领域存在着诸多漏洞,从无线智能玩偶到重达数吨的汽车,无一幸免。好的方面是,这也令越来越多的公司关注并重视物联网的安全问题。
如今,越来越多的员工都已经在家中部署了各种各样的物联网设备,甚至还会将这些设备连接企业网络进行办公,如此一来,势必会引爆更大的安全危机。与此同时,工业物联网也正面临同样的安全问题,员工所拥有并使用的物联网系统已经成为影响工业物联网安全的第二个主要威胁面。
本文延续该系列的上一篇 深度学习优化函数详解(0)– 线性回归问题。
上一篇讲到了最基本的线性回归问题,最终就是如何优化参数 a, b 寻找最小的 loss
<center><img src="http://imgtec.eetrend.com/sites/imgtec.eetrend.com/files/201808/blog/17…; alt="深度学习优化函数详解(1)——Gradient Descent 梯度下降法"></center>
在走进深度学习的过程中,最吸引作者的是一些用于给对象分类的模型。最新的科研结果表示,这类模型已经可以在实时视频中对多个对象进行检测。而这就要归功于计算机视觉领域最新的技术革新。
众所周知,在过去的几年里,卷积神经网络(CNN或ConvNet)在深度学习领域取得了许多重大突破,但对于大多数人而言,这个描述是相当不直观的。因此,要了解模型取得了怎样大的突破,我们应该先了解卷积神经网络是怎样工作的。
<font size="3"><strong>卷积神经网络可以做些什么?</strong></font>
目前,人工智能,机器学习,深度学习,计算机视觉等已经成为新时代的风向标。
这篇文章主要介绍了下面几点:
第一点,如果说你要入门计算机视觉,需要了解哪一些基础知识?
第二点,既然你要往这方面学习,你要了解的参考书籍,可以学习的一些公开课有哪些?
第三点,可能是大家都比较感兴趣的,就是计算机视觉作为人工智能的一个分支,它不可避免的要跟深度学习做结合,而深度学习也可以说是融合到了计算机视觉、图像处理,包括我们说的自然语言处理,所以本文也会简单介绍一下计算机视觉与深度学习的结合。
第四点,身处计算机领域,我们不可避免的会去做开源的工作,所以本文会给大家介绍一些开源的软件。
到目前为止,我们都还不完全清楚开始机器学习需要什么样的数学水平,特别是那些没有在学校学习数学或统计学的人。
在这篇文章中,我的目标是提出建立产品或进行机器学习学术研究所需的数学背景。这些建议源于与机器学习工程师、研究人员和教育工作者的对话以及我在机器学习研究和行业角色方面的经验。
首先,我会提出不同的思维模式和策略,以便在传统课堂之外接近真正的数学教育。然后,我将概述不同类型的机器学习工作所需的具体背景,这些学科的范围涉及到高中统计和微积分到概率图形模型(PGM)。
<font color="#33b1c8"><strong>关于数学焦虑的一个解释</strong></font>
事实证明,很多人包括工程师都害怕数学。首先,我想谈谈“善于数学”的神话。
随着人工智能变得越来越聪明,关于AI将消灭人类的说法也不断涌现出来。事实上,很多大人物都在呼吁人们提起警惕。到现在,似乎AI支持者谷歌首席工程师雷·库兹韦尔对未来的乐观态度似乎已经不敌比尔·盖茨、伊隆·马斯克和史蒂芬·霍金提出的担忧。
诚然,我们确实有理由表示担忧,但未来并不一定会是一个黑暗的未来,因为我们可以有利用AI的更好方式,关键是认识到人类与机器智能之间的互补关系。说到底,人工智能与人类智能有着天壤之别,所以以后可以停止对二者的比较了。
如今,人们很容易相信人工智能已经变得像人类智慧一样聪明了——如果不是更聪明的话。比如,前一段时间,谷歌发布了Duplex AI,能够帮助用户完成外呼预定美发沙龙和餐馆等操作。由于它的声音几乎与人类一模一样,所以在整个过程中可以瞒过其对话伙伴,使之认为自己是人类。
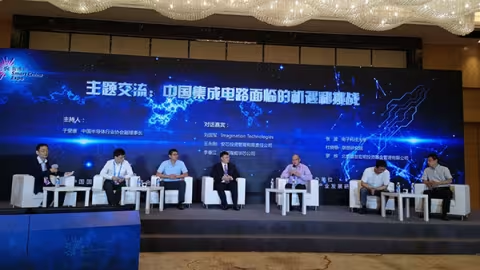
2018年8月23日-25日,首届中国国际智能产业博览会在重庆举行。本届博览会由科学技术部、工业和信息化部、中国科学院、中国工程院、中国科学技术协会和重庆市人民政府共同举办。Imagination Technologies副总裁兼中国区总经理刘国军出席了首届智博会半导体产业高端论坛,并介绍了Imagination在人工智能等领域内的优势、技术、产品、以及与中国芯片企业的合作规划。
在做一些深度学习的算法的时候,都会用到优化函数,在各种成熟的框架中,基本就是一行代码的事,甚至连默认参数都给你设置好了,基本不用动什么东西,最后也会有比较好的优化结果。但是对于优化函数这么核心,这么基本的东西总是模棱两可实在不应该。于是想自己把一些常用的优化函数从原理上搞清楚,所以才有了这个系列的文章。每一篇文章都有配套的python代码,文末会给出地址。
线性回归问题(Linear Regression)

我从实践中学习了到这些方法。相对于理论,我一向更热衷于实践。这种学习方式也一直在激励我。本文将分享 8 个经过证实的方法,使用这些方法可以建立稳健的机器学习模型。希望我的知识可以帮助大家获得更高的职业成就。
<font size="3" color="#33b1c8"><strong>导语</strong></font>
提升一个模型的表现有时很困难。如果你们曾经纠结于相似的问题,那我相信你们中很多人会同意我的看法。你会尝试所有曾学习过的策略和算法,但模型正确率并没有改善。你会觉得无助和困顿,这是 90% 的数据科学家开始放弃的时候。
一个典型的基于视频图像的人脸识别系统一般都是自动检测人脸区域,从视频中提取特征,最后如果人脸存在则识别出人脸的身份。在视频监控、信息安全和出入控制等应用中,基于视频的人脸识别是一个非常重要的问题,也是目前人脸识别的一个热点和难点。基于视频比基于静态图像更具优越性,因为 Bruce 等人和 Knight 等人已证明,当人脸被求反或倒转时,运动信息有助于(熟悉的)人脸的识别。虽然视频人脸识别是基于静态图像的人脸识别的直接扩展,但一般认为视频人脸识别算法需要同时用到空间和时间信息,这类方法直到近几年才开始受到重视并需要进一步的研究和发展。
视频人脸识别遇到的困难和挑战,具体来说有以下几种:
作者:Jason Brownlee
译者:刘小芹
【导读】作者在本文提出一种5步入门并应用机器学习的方法。它不是传统的方法。传统的机器学习方法提倡从下往上学,先从理论和数学开始,然后是算法实现,最后让你去解决现实世界的问题。
opencv中提供的基于haar特征级联进行人脸检测的方法效果非常不好,本文使用dlib中提供的人脸检测方法(使用HOG特征或卷积神经网方法),并使用提供的深度残差网络(ResNet)实现实时人脸识别,不过本文的目的不是构建深度残差网络,而是利用已经训练好的模型进行实时人脸识别,实时性要求一秒钟达到10帧以上的速率,并且保证不错的精度。opencv和dlib都是非常好用的计算机视觉库,特别是dlib,前面文章提到了其内部封装了一些比较新的深度学习方法,使用这些算法可以实现很多应用,比如人脸检测、车辆检测、目标追踪、语义分割等等。由于这两个库相应的都包含了C++和Python的版本,而Python的配置和相对使用起来更加简单,因此这篇文章主要通过Python来实现。
卷积在信号处理领域有极其广泛的应用,也有严格的物理和数学定义。本文只讨论卷积在数字图像处理中的应用。
在数字图像处理中,有一种基本的处理方法:线性滤波。待处理的平面数字图像可被看做一个大矩阵,图像的每个像素对应着矩阵的每个元素,假设我们平面的分辨率是 1024 * 768,那么对应的大矩阵的行数= 1024,列数=768 。
用于滤波的是一个滤波器小矩阵(也叫卷积核),滤波器小矩阵一般是个方阵,也就是行数和列数相同,比如常见的用于边缘检测的 Sobel 算子 就是两个 3*3 的小矩阵.
进行滤波就是对于大矩阵中的每个像素,计算它周围像素和滤波器矩阵对应位置元素的乘积,然后把结果相加到一起,最终得到的值就作为该像素的新值,这样就完成了一次滤波。
上面的处理过程可以参考这个示意图:
语义分割是计算机视觉中的基础任务,我们通常会使用基于 CNN 加 CRF 的方法或直接使用对抗性的训练实现端到端的分割。本文简要介绍了这两种方法及它们的特点。
人类是如何描述场景的?我们可能会说「窗户下有一张桌子」,或者「沙发右边有一盏灯」。图像理解的关键在于将一个整体场景分解成几个单独的实体,这也有助于我们推理目标的不同行为。
当然,目标检测方法可以帮助我们绘制某些确定实体的边框,但人类对场景的理解能以像素级的精细程度对每一个实体进行检测并标记精确的边界。我们已经开始发展自动驾驶汽车和智能机器人,这些都需要深入理解周围环境,因此精确分割实体变得越来越重要。
<font size="3"><strong>什么是语义分割?</strong></font>
聚类属于无监督学习,事先不知道数据会分为几类,通过聚类分析将数据聚合成几个群体。聚类是不需要对数据进行训练和学习的。主要的聚类算法有K-Means和DBSCAN。
K-Means算法的基本原理比较简单:
1.指定K值(数据要分成的簇的数目),并指定初始的k个质心;
2.遍历每个数据点,计算其到各个质心的距离,将其归类到距离最近的质心点;
3分类完毕后,求各个簇的质心,得到新的质心点;
4.重复2和3中的操作,计算新的质心与旧的质心之间距离,如果小于设定的误差值,则停止计算,否则继续进行迭代。
object detection我的理解,就是在给定的图片中精确找到物体所在位置,并标注出物体的类别。object detection要解决的问题就是物体在哪里,是什么这整个流程的问题。然而,这个问题可不是那么容易解决的,物体的尺寸变化范围很大,摆放物体的角度,姿态不定,而且可以出现在图片的任何地方,更何况物体还可以是多个类别。
object detection技术的演进:
RCNN->SppNET->Fast-RCNN->Faster-RCNN