你有没有想过,手机为什么能在一瞬间认出照片里的人脸?自动驾驶汽车又为什么能认出路边的停车标志?答案指向一类强大的人工智能技术——卷积神经网络(Convolutional Neural Network,CNN)。
到了 2026 年,CNN 依然是蓬勃发展的计算机视觉市场背后的核心引擎。据预测,这个市场到 2034 年将价值 728 亿美元。受人类大脑处理图像的方式启发,这类网络已经学会了如何"看"世界,并解读这个世界。
这篇指南将拆解 CNN 究竟是什么、它如何工作,以及它在现实世界中那些强大的应用。
核心要点速览
- 2026 年,先进的卷积神经网络在物体识别上的准确率已超过 99%,超越人类视觉表现,并推动着价值数十亿美元的全球计算机视觉市场。
- 现代架构动用 150 多个专用层和超过 1 亿个参数,把原始像素自动转换成复杂模式乃至完整物体的层级化表示。
- 经过优化的网络只需几毫秒就能完成图像分类,从而支撑起图像识别、医学诊断以及自然语言处理中的高级模式检测等高速应用。
- 通过卷积与池化的反复迭代,这类网络在简化视觉数据的同时,借助正则化防止过拟合,确保在全新的、未见过的数据集上也能可靠工作。
CNN 到底是什么?
卷积神经网络(CNN)是一种专门为理解和处理图像而设计的人工智能。它是让计算机获得某种"视觉"能力的核心技术,使计算机能够识别物体、人物和场景。
这项技术的能力极其强大。2026 年,最顶尖的 CNN 识别图像中物体的准确率已超过 99%,这一水平往往超越人类表现。正是这种能力,撑起了价值数十亿美元的计算机视觉市场。
CNN 有两个关键特性,让它的效果如此出色。
它像我们一样学习
CNN 的设计灵感来自人类大脑的视觉皮层。当你看向某个东西时,大脑首先捕捉到的是线条、边缘、拐角这类简单形状;随后,它把这些简单模式组合起来,识别出更复杂的对象,比如一张脸或一辆车。
CNN 的运作方式如出一辙:
- 在最前面的层里,它学习识别颜色、边缘这类基础特征。
- 在更深的层里,它把这些基础特征组合起来,识别纹理、形状等更复杂的模式。
- 在最后的层里,它再把这些模式组合起来,识别出完整的物体。
它能自己学习
这是 CNN 最大的优势。在这项技术出现之前,程序员必须手动编写代码,告诉计算机该去找什么。举例来说,他们得靠尖耳朵、胡须和尾巴来定义一只猫。
CNN 改变了这一切。你不必告诉 CNN 猫长什么样,只要给它看成千上万张猫的图片,网络就会自己学会识别关键特征。正是这种自动化的学习过程,让 CNN 如此精准,也正是它成为现代计算机视觉基础的原因。
为什么 CNN 在 2026 年依然重要
现代视觉的基石
卷积神经网络(CNN)依然是计算机视觉领域众多生产系统的骨干。从图像分类、目标检测,到医学影像、遥感与视频分析,它们持续支撑着关键应用。其成熟度与广泛采用,使它成为一个可靠的默认选择——团队信任 CNN,因为它们容易理解、效率高,而且有大量成熟的教材与研究。
效率与部署
CNN 针对 GPU、NPU 和移动端芯片做了高度优化,往往比纯视觉 Transformer(Vision Transformer,ViT)模型提供更快的性能和更低的延迟,在边缘设备和移动设备上尤其如此。在算力、功耗或内存受限的场景中,MobileNet、EfficientNet 这类轻量变体依然是首选。这种效率,保证了 CNN 在真实世界的落地部署中不可或缺。
CNN 的核心原理与架构
仅仅一个图像识别任务,比如在一张照片里认出猫,就可能需要现代 CNN 执行数十亿次计算。据估算,2026 年,CNN 在各种应用中合计每天要处理超过 1000 亿张图像。
如此惊人的工作量,由一系列专用层像流水线一样协同完成。每一层都有明确的分工。
CNN 各层速览
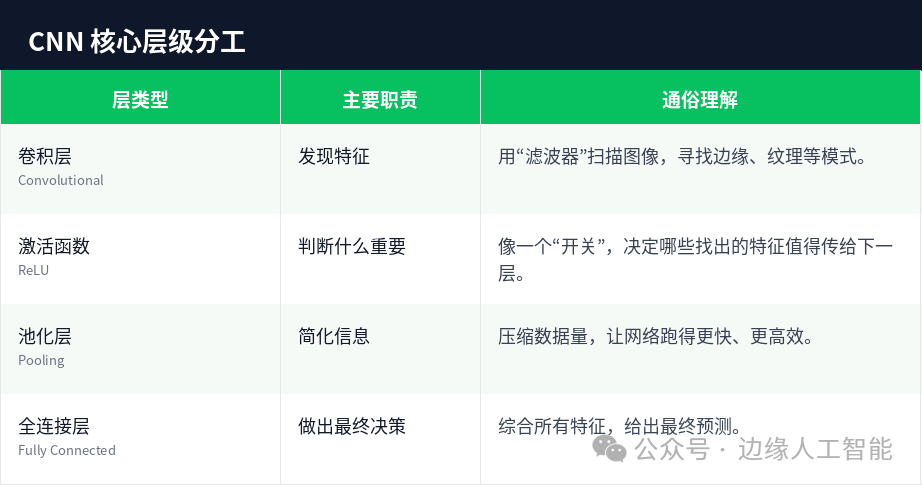
表格 1
CNN 并不是单一的东西,而是一系列各司其职的层。现代网络极其复杂。2026 年一些最强大的 CNN 拥有超过 150 层、超过 1 亿个"参数"——这些参数是机器学习算法在学习过程中不断调整的内部旋钮。
下面我们拆解几乎每个 CNN 都会出现的三类主要层。
卷积层(特征发现者)
这是 CNN 的第一层,也是最重要的一层。它使用数十甚至数百个数字"滤波器"在输入图像上扫描。每个滤波器都像一位微型的专家,专门负责找出某一种特定特征。
- 在最前面的层里,滤波器寻找非常简单的元素:直线、拐角和颜色。
- 在更深的层里,网络把这些元素组合起来,寻找更复杂的模式,比如毛发的纹理、眼睛的形状,或者汽车翼子板的曲线。
激活函数("开关")
某个特征被找到后,会经过一个激活函数。最常见的一种叫 ReLU。它的工作很简单:判断这个特征是否足够重要,可以传给下一层。它就像一个开关,把重要的特征打开,把其余的忽略掉。正是这一步,让网络能够学习非常复杂、非线性的模式。
池化层(简化者)
卷积层找出成千上万个特征之后,数据量会非常庞大。池化层的工作就是简化这些信息。它只保留图像每一小块区域中最重要的特征,从而把数据压缩下来。这带来两个关键好处:
- 让网络更快、更高效。
- 帮助网络在物体发生轻微位移或旋转时依然能认出它。
全连接层(决策者)
这是最后一步。数据经过许多层特征发现者和简化者之后,会被摊平成一份单一的清单。这份高层次特征的清单,随后被送入全连接层。
这最后一层会综合所有证据,做出预测。举例来说,它可能看到"有尖耳朵""有胡须""有毛"这样一串特征,然后得出:"这张图片有 99% 的概率是一只猫。"
CNN 的数据处理流程(从输入到输出)
现代 CNN 不只是准确,速度也快得惊人。2026 年,经过优化的网络只需几毫秒就能完成一次图像分类——比眨一下眼还快。这种速度来自一套高效的分步流程,它就像一条理解图像的数字流水线。
下面看看一张照片如何一步步变成最终的预测结果。
第一步:输入——图像变成数字
首先,计算机看到的并不是一张狗的图片,而是一个由数字组成的网格。每个数字代表单个像素的颜色和亮度。这个数字网格,就是网络接下来要分析的原始数据。
第二步:特征提取——发现并简化线索
接着,图像数据会穿过一系列反复出现的层,这些层负责找出并简化重要特征。这个循环,正是 CNN 的核心。
- 卷积: 网络用"滤波器"扫描图像,寻找边缘、拐角、纹理这类基础模式。
- 激活(ReLU): 再由一个"开关"决定哪些特征足够重要,可以继续传递。
- 池化: 网络简化信息,只保留每个特征中最重要的部分。这让整个流程更快。
这个循环——卷积、激活、池化——会重复很多次。每循环一次,网络就能识别更复杂的特征,比如一只眼睛、一个车轮或一片叶子。
第三步:展平——把证据排成一列
所有特征提取完毕后,数据以一组二维"特征图"的形式存在。为了进入最后一步,这些数据会被展平成一长串数字。这就像调查员把犯罪现场的所有线索收集起来,一条条摆在桌上逐一审视。
第四步:分类——做出最终判断
这份单一的特征清单被送入最后的"全连接"层。网络的这一部分会审视完整的证据清单,做出最终判断。它权衡找到的所有特征,计算出不同结果的概率,给出诸如 "99% 是狗"、"1% 是猫" 这样的最终预测。
CNN 的训练与优化
2026 年,训练一个大型 AI 模型是一项庞大的工程,有时仅算力成本就要数百万美元。这个昂贵而复杂的过程,核心目的只有一个:教网络把本职工作做得更好。
可以把它想象成一个正在备考大考的学生。这个过程包含几个关键步骤。
目标:拿到好分数(损失函数)
首先,网络对一张图像做出猜测(比如"这是一只猫")。接着,我们把它的猜测与正确答案做比较。损失函数是一个公式,它根据网络错得有多离谱给出一个"分数"。训练的终极目标,就是把这个错误分数压到尽可能低。
它如何学习:核对答案(反向传播)
这是学习过程中最重要的部分。网络审视自己的错误分数,然后从后往前逐层回溯,找出是哪些内部连接对这次错误贡献最大。这个过程叫反向传播(backpropagation)。这就像老师明确告诉学生,哪几道题做错了、为什么错,学生才知道该复习什么。
它如何避免"作弊":防止死记硬背(正则化)
AI 领域的一个常见问题是过拟合。当网络只是把训练图像背下来,而没有学到物体的真实特征时,就会发生这种情况。这就像一个学生把练习题的答案全背熟了,但换一道稍有变化的题就答不出来,因为他并没有真正掌握这门知识。
为了防止这种情况,我们会使用正则化技术。
- Dropout 是一种流行的方法:训练时随机关掉网络中的一部分。这会迫使网络以更通用的方式学习特征,无法只依赖某一条信息。
- 数据增强 则是通过对现有图像做轻微改动(比如旋转、翻转、裁剪)来制造更多训练数据。这等于告诉模型:即使外观略有不同,物体依然是同一个。
最后一个挑战:"黑箱"问题
即便 CNN 的准确率很高,人类往往也很难理解它究竟是如何做出这个决定的。这种缺乏透明度的现象被称为"黑箱"问题。在医学或自动驾驶这类需要信任 AI 推理过程的领域,这是一个重大挑战。让 AI 变得更具"可解释性",是当下一个重要的研究方向。
CNN 都用在哪里?
卷积神经网络(CNN)正在改变几乎每一个行业。2026 年,主要由 CNN 应用驱动的全球人工智能市场,预计将突破 1 万亿美元。虽然它们以帮助计算机"看见"而闻名,但它们在现实世界中的用途远不止于此。
以下是 CNN 正在产生重大影响的一些关键领域。
- 图像与视频识别:这是最经典的应用场景。手机上的面部识别、自动驾驶汽车识别行人、社交媒体平台自动过滤不当内容,背后的技术都是 CNN。
- 医学影像分析:CNN 正成为医生的强大工具。它们可以分析 X 光、CT 和 MRI 等医学扫描影像,帮助更早、更准确地发现癌症或肺炎等疾病。在某些诊断任务中,它们的准确率已超过 95%,成为放射科医生的得力助手。
- 自然语言处理(NLP):虽然以图像见长,CNN 在文本模式识别方面同样出色。它们被用于情感分析(判断一条客户评价是正面还是负面)以及按主题给文章分类等任务。
- 时间序列预测:CNN 可以被改造用来分析随时间变化的数据,从而预测接下来会发生什么。这在金融领域用于预测股价,在零售领域用于预测产品需求。
- 语音识别:CNN 也是把你说的话转成文字的系统中的关键一环。它们为 Siri、Alexa 和 Google Assistant 等虚拟助手的语音指令功能提供支撑。
CNN 的挑战与局限
CNN 虽然强大,但也有局限。它最大的挑战是极度渴求数据。2026 年,一个大型商用 CNN 用超过 1000 万张标注图像的数据集来训练,并不罕见。理解这些局限以及其他问题,非常重要。
以下是使用 CNN 时的一些关键挑战:
- 数据密集:CNN 需要大量、精细标注的数据集来训练。获取足够的数据,尤其是在医学影像这类细分领域,既困难又昂贵。
- 算力成本高:训练深度 CNN 需要大量计算资源,往往离不开昂贵的专用硬件(GPU),对企业来说是一笔不小的投入。
- 上下文局限:CNN 擅长识别局部模式,但在理解更大范围的场景,或识别处于不寻常朝向、旋转角度的物体时,可能力不从心。
- 缺乏可解释性("黑箱"问题): 一大挑战在于,即便预测非常准确,我们也难以理解 CNN 得出该预测的推理过程。在医学、金融这类"为什么"至关重要的领域,这种缺乏透明度可能是致命的。
近期进展与未来方向
AI 模型的演进速度快得惊人。仅 2026 年一年,预计就将发表超过 20 万篇人工智能相关研究论文。这种快速的创新,正把计算机视觉推向传统 CNN 之外令人兴奋的新方向。
以下是塑造这项技术未来的一些最重要的趋势。
- 视觉 Transformer(ViT):新的挑战者。 一种名为视觉 Transformer 的新型网络正变得越来越流行。CNN 擅长发现局部细节,而 ViT 的设计目标是同时看到"全局画面"。这使它在理解复杂场景的整体上下文方面非常强大。
- 混合模型:两全其美。 研究者如今把 CNN 和 ViT 结合起来。这类混合模型用 CNN 找出重要的局部细节,再用 ViT 理解这些细节如何在更大的图像中彼此关联。
- 用更少的数据学习。CNN 最大的局限在于需要海量标注数据集。"自监督"和"小样本"学习等新方法正在被开发出来,教 AI 从远少于以往的样本中学习,让这项技术更易获得。
- 可解释 AI(XAI):打开黑箱。 一个重要目标是让 AI 的决策不再那么神秘。XAI 是一个研究领域,专注于构建工具,帮助我们理解网络为什么会做出某个预测。这对于在医学等高风险领域建立信任至关重要。
- 迁移学习:给 AI 一个先发优势。 开发者不必从零训练一个新网络,而可以使用"预训练"模型。他们拿来一个已经在数百万张通用图像上训练成专家的模型,再针对新的具体任务快速"微调"。这节省了大量时间和资源。
结语
2026 年,全球人工智能市场正一路攀升,逼近 1 万亿美元,而这其中的很大一部分价值,由卷积神经网络(CNN)的力量驱动。
正是这项技术,让我们的计算机能够"看见"。CNN 是面部识别、医学扫描分析和自动驾驶汽车背后的引擎。它们学会在图像中寻找模式,从简单的边缘开始,一层层构建出复杂的物体,其过程与人类大脑颇为相似。
一个强大的 AI 模型,是任何现代 IT 解决方案的骨干。作为专业的 AI 构建者,我们专注于为客户打造这些智能引擎,把视觉转化为价值。准备好把你的项目建立在坚实的基础上?现在就联系我们,预约一次 2 小时的咨询,从今天开始搭建属于你的 AI 的 CNN 数据库。
常见问题
1. 在图像处理上,CNN 为什么比传统神经网络更好?
传统神经网络把图像当作一串扁平的数字,丢失了像素之间的空间关系。CNN 使用"卷积层",通过滤波器扫描图像,因而能够理解空间层级关系(比如线条如何构成形状、形状如何构成物体)。这让它效率更高、也更准确——在现代计算机视觉任务中,准确率往往超过 99%。
2. CNN 是如何"看见"并解读一张图像的?
CNN 通过一条由四个主要步骤组成的"数字流水线"处理数据:
- 输入: 图像被转换为一个代表像素值的数字网格。
- 特征提取: 滤波器扫描图像,寻找模式(边缘、颜色和纹理)。
- 展平: 二维/三维数据被转换成一维的证据清单。
- 分类: 最后一层根据提取到的特征做出判断(比如"这是一辆车")。
3. CNN 架构中有哪些核心层?
大多数现代 CNN 都由以下这些基本层的组合构成:
- 卷积层: 即"特征发现者",通过滤波器检测模式。
- 激活函数(ReLU): 像一个"开关",决定哪些特征足够重要、值得继续传递。
- 池化层: 即"简化者",在保留最关键信息的同时减少数据量,让流程更快。
- 全连接层: 即"决策者",利用收集到的特征对图像进行分类。
4. 开发者如何防止 CNN 只是"背题"?
这个问题被称为过拟合。为了确保模型能识别新的、未见过的图像,而不只是死记训练集,开发者会使用"正则化"技术:
- Dropout: 训练时随机关掉网络的一部分,迫使它寻找不同的学习路径。
- 数据增强: 通过旋转、翻转或裁剪原始训练图像,制造更多变化。
5. CNN 只用于图像和视频识别吗?
虽然 CNN 以赋予计算机"视觉"而闻名(用于面部识别和医学影像),它在其他领域同样非常高效:
- 自然语言处理(NLP): 在文本中寻找模式,进行情感分析。
- 医学影像分析: 帮助医生以高精度检测 X 光或 MRI 中的异常。
- 边缘 AI: 在移动设备本地运行,处理数据以获得更快的速度和更好的隐私保护。
参考文献:
“Convolutional Neural Networks in 2026: Architecture & Applications”
https://vinova.sg/convolutional-neural-networks-architecture-applications/
本文转自:边缘人工智能,转载此文目的在于传递更多信息,版权归原作者所有。如不支持转载,请联系小编demi@eetrend.com删除。


