我们每天使用电脑、手机,打开一个程序、进行一次计算,看起来只需要轻轻点击一下。但在CPU内部,一切都要从一条条最基本的机器指令开始。例如,在RISC-V处理器中,一条简单的加法指令:ADD x5,x6,x7。它的意思是:把寄存器x6和x7中的数据相加,并将结果写入x5。对于程序员来说,这可能只是一行简单的汇编代码。但对于CPU来说,它却意味着一系列连续的动作:取出指令→识别指令→读取数据→完成计算→保存结果→准备执行下一条指令。
那么,一个问题就来了,一条RISC-V指令,究竟是怎样从存放在内存中的一串二进制数据,变成CPU真正完成的一次计算的?今天,我们就跟随ADD x5,x6,x7这条指令,走进RISC-V CPU内部,看看一条指令的完整旅程。
CPU先找到这条指令
CPU怎么知道下一条指令在哪里?
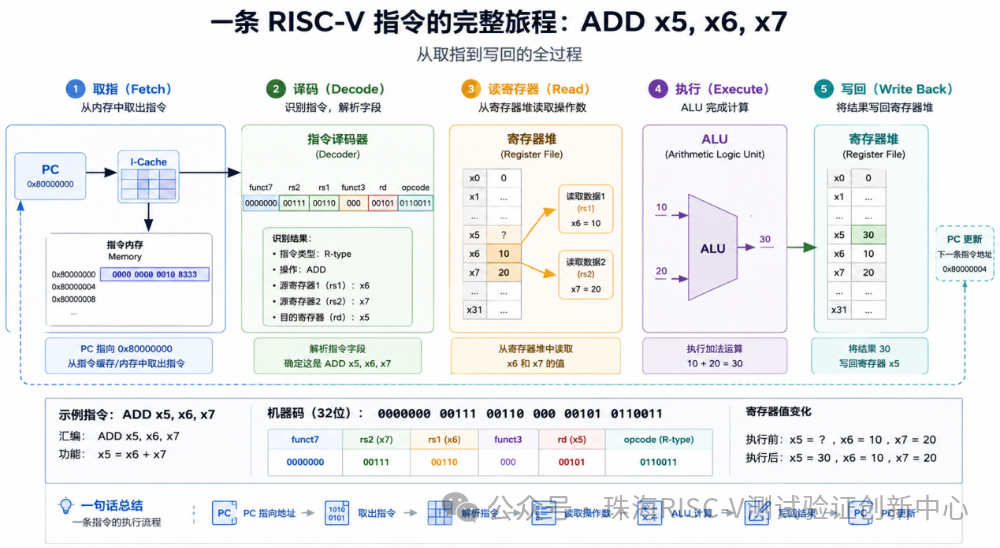
CPU执行程序,并不是随意从内存中读取指令,而是按照一定的顺序执行。这里有一个非常重要的寄存器,PC(Program Counter)程序计数器。PC并不是用来保存程序本身,而是用来记录下一条要执行的指令在哪里?假设我们的程序从某个地址开始,PC当前指向0x80000000。那么CPU就知道,需要从这个地址取出对应的指令。在典型的RISC-V指令执行过程中,PC会随着程序运行不断变化。例如,一条普通的32位指令执行后,PC通常会向后移动4字节。所以,可以简单理解为,PC就像CPU手里的地址导航器,不断告诉CPU下一步应该去哪里取指令。
CPU开始取指
当PC指向0x80000000时,CPU首先要做的事情就是从指令存储系统中读取这个地址对应的指令。这一步叫做Instruction Fetch,取指。指令可能来自不同层级的存储系统。CPU通常不会每次都直接访问速度较慢的主存,而是优先检查高速的指令Cache,也就是我们经常说的I-Cache。如果指令已经存在Cache中,CPU就可以快速获得它。如果没有命中,则需要从更低层级的存储系统获取。最终,CPU获得了一串二进制数据。例如0000000 ...... 00101 ...... 00110 ...... 00111 ...... 0110011。对于人类来说,这只是一串0和1。但对于CPU来说,这里面包含着非常重要的信息,这是什么指令?操作哪些寄存器?结果应该放在哪里?
取出来以后,CPU还不知道它是什么
注意一个容易产生误解的地方,CPU把指令取出来,并不代表已经完成了计算。现在CPU只是拿到了题目。就像我们拿到一道数学题之后,还需要先看懂题目,才能开始计算。因此,下一步就是译码。
CPU开始读懂这条指令
译码,从二进制中识别指令
RISC-V指令并不是随意排列的一串二进制数字。以经典的R型指令为例,一条32位指令中包含多个字段,例如opcode操作码,rd目的寄存器,rs1源寄存器1,rs2源寄存器2,funct3,funct7。对于ADD x5, x6, x7,CPU需要从这32个比特中拆解出这些信息。它首先通过 opcode判断这是一类什么操作?随后结合 funct3、funct7 等字段进一步确定这是ADD,而不是SUB。与此同时,CPU还识别出x6是第一个源寄存器,x7是第二个源寄存器,x5是最终结果的目的寄存器。也就是说,经过译码以后,CPU已经知道要把x6和x7中的数据进行加法运算,然后把结果写进x5。
从寄存器中读取数据
接下来,CPU需要找到真正参与计算的数据。假设当前x6=10,x7=20,那么CPU需要从寄存器堆中读取这两个值。RISC-V拥有一组通用寄存器。以RV64为例,每个通用寄存器的宽度为64位。CPU根据指令中的rs1和rs2字段,找到x6和x7,并将其中的数据送入后续的执行单元。于是,现在CPU已经准备好了操作数A=10,操作数B=20。
真正的计算
现在轮到CPU中的计算器登场了。它就是ALU——Arithmetic Logic Unit,算术逻辑单元。ALU可以完成很多基本操作,例如加法、减法、与、或、异或、移位、比较等。对于我们的ADD指令来说,任务非常简单,10+20=30,ALU完成计算后得到30。但此时还不能算真正结束,因为CPU还需要回答最后一个问题,这个30应该放在哪里?答案已经写在指令里面,x5。
结果写回,CPU准备下一条指令
写回寄存器
计算完成后,结果会被送回寄存器堆,也就是,x5←30。此时x6仍然是10,x7仍然是20,x5变成30。至此,ADD x5, x6, x7 这条指令的核心任务完成。可以把整个过程简单概括为,PC→取指→译码→读寄存器→ALU计算→写回寄存器。这就是经典的指令执行流程。
CPU并不是做完一条再做下一条
看到这里,可能有人会产生一个疑问,如果CPU每执行一条指令,都要经历这么多步骤,那现代CPU为什么还能做到每秒执行数十亿次操作?关键就在于流水线。现代处理器通常不会傻傻地等一条指令完全执行结束后,才开始处理下一条。例如第一条指令正在执行的时候,第二条指令可以进行译码,第三条指令甚至已经开始取指。于是,不同指令可以同时处于不同阶段。就像工厂流水线一样第一道工序加工产品A时,第二道工序可以加工产品B,第三道工序还可以加工产品C。这样,CPU就可以大幅提高指令吞吐能力。
遇到不同指令,流程也会发生变化
刚才我们选择的是最简单的ADD指令。但RISC-V中的指令种类很多,不同指令的执行过程也有所不同。比如LOAD指令,它不仅需要计算地址,还需要访问Cache或内存,把数据读取回来。大致过程是取指→译码→计算地址→访问内存→数据返回→写回寄存器。再比如STORE指令,它需要把寄存器中的数据写入内存。而遇到BEQ等分支指令,CPU则需要判断条件是否成立,并决定下一条指令究竟在哪里。这时候,PC就不能简单地每次向后移动4字节。如果分支判断出现变化,还可能影响流水线中已经提前取出的指令。这也是为什么现代CPU需要分支预测、流水线控制等复杂机制。
结语
从程序员的角度看ADD x5, x6, x7,只是一条加法指令。但从CPU的角度看,它经历了一次完整的执行过程,PC找到指令→CPU取出指令→译码器识别指令→从寄存器读取数据→ALU完成计算→结果写回寄存器→PC指向下一条指令。而这还只是最简单的一种情况。当CPU面对Load、Store、分支、乘除法、浮点、向量等不同类型的指令时,背后还会涉及Cache、流水线、分支预测、乱序执行、异常处理等更加复杂的机制。
这也揭示了一个非常重要的概念,RISC-V定义的是CPU应该理解什么指令,而具体怎样把这些指令高效地执行出来,则属于处理器微架构设计的范畴。因此,即使两颗CPU都采用RISC-V指令集,它们内部也可以拥有完全不同的流水线、Cache、执行单元和性能表现。同样的语言,可以有不同的说话方式,RISC-V真正有意思的地方,也正是在这里。下一次,当你看到一条RISC-V汇编指令时,不妨换一个角度去看它,它不只是一行代码,还是CPU内部一次完整接力的起点。
本文转自:珠海RISC-V测试验证创新中心,转载此文目的在于传递更多信息,版权归原作者所有。如不支持转载,请联系小编demi@eetrend.com删除。