循环神经网络(RNNs)是基于序列的模型,对自然语言理解、语言生成、视频处理和其他许多任务至关重要。模型的输入是一个符号序列,在每个时间点一个简单的神经网络(RNN单元)应用于一个符号,以及此前时间点的网络输出。RNNs是强大的模型,在许多任务中表现出色,但会快速过拟合。RNN模型中缺少正则化使他难以处理小规模数据,为避免这种情况研究者经常使用提早停止,或者小规模的或未充分定义的模型。
Dropout是深度网络中常见的一种正则化技巧,在训练过程中网络单元随机的被隐藏/丢弃。但这种技巧在RNNs中一直未被成功应用。实证结果使很多人相信循环层(RNN单元之间的连接)中加入的噪音在长序列中会被放大,并淹没了信号。因此现存的研究认为这种技巧应仅用于RNN的输入和输出。但这种方式在研究中发现依然会导致过拟合。

卷积神经网络的发展主要是为了解决人类视觉问题,不过现在其它方向也都会使用。发展历程主要从Lenet5->Alexnet->VGG->GooLenet->ResNet等。
<font size="3" color="blue"><strong>Lenet5</strong></font>
上世界80年代发明了卷积层,但由于硬件限制无法构建复杂网络,直到后面90年代才开始有实践。
无人驾驶是百年汽车工业的一个崭新高度,也是人们对智慧出行梦寐以求的目标。
今年以来,从拉斯维加斯电子商品展上各种无人驾驶技术的高调亮相,到许多汽车和科技公司陆续对无人驾驶商业计划的激进宣示,一些媒体开始大肆宣称无人驾驶会比人们想象的时间更早到来。
当前社会上和业界弥漫着一种浮躁,似乎无人驾驶就在眼前,谁不抓住它就会被淘汰,造成了资本市场的压力和业界的普遍焦虑。
无人驾驶真的指日可待了吗?
我的回答非常简单:否。不仅否,还非常遥远。
<font size="3"><strong> 主观能动性是无人驾驶的必要条件</strong></font>
要问为什么,首先要了解什么是无人驾驶和我们需要怎么样的无人驾驶。
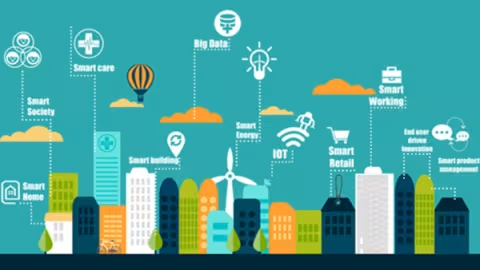
新型智慧城市,是指运用信息和通信技术手段,感测、分析、整台城市运行核心系统的各项关键信息,从而对包括民生、环保、公共安全、城市服务、工商业活动在内的各种需求做出智能响应。它不单是仅仅基于某一种技术,而是包括云,人工智能等等技术的综合应用解决方案,旨在帮助城市更好运转,为人们创造更美好的生活。
新型智慧城市主要应用领域包括:智慧政务、智慧交通、智慧安防、智慧教育、智慧医疗。
<font color="blue"><strong>智慧政务:政务云建设加速,云计算、大数据以及AI等新技术不断落地</strong></font>
很早的时候就想写几篇关于人工智能的东西,把人工智能的东西写的通俗易懂点,但是毕竟人工智能的东西涉及的领域太广了,特别是对数学和概率有比较深的理解,如果只是想简单的了解,可以跳过文章的公式。
很难想象有什么事物会像廉价、强大、无处不在的人工智能那样拥有“改变一切”的力量。《必然》
前段时间的AlphaGo再次的把人工智能炒的火热,关于人工智能的讨论又再次进入讨论的风口浪尖上。各个方面对AlphaGo技术的猜测,神经网络也再次成为了技术的焦点。
<font size="3"><strong>一个看似简单的问题</strong></font>
<font color="#FD8900">作者: 张俊红</font>
在机器学习中,同一个数据集可能训练出多个模型即多个函数(如下图所示,同样的数据集训练出三种不同的函数),那么我们在众多函数中该选择哪个函数呢?首选肯定是那个预测能力较好的模型,那么什么样的函数/模型就是预测好的呢?有没有什么评判标准?
<font size="3"><strong>背景介绍</strong></font>
图像拼接是一项应用广泛的图像处理技术。根据特征点的相互匹配,可以将多张小视角的图像拼接成为一张大视角的图像,在广角照片合成、卫星照片处理、医学图像处理等领域都有应用。早期的图像拼接主要是运用像素值匹配的方法。后来,人们分别在两幅图像中寻找拐点、边缘等稳定的特征,用特征匹配的方法拼接图像。本实验根据Matthew Brown (2005) 描述的方法,实现多张生活照的拼接。
<font size="3"><strong>特征点捕捉 (Interest Point Detection)</strong></font>
人脸检测应用极为广泛,内部细节也偏多,尤其是涉及到几种类型的框,这几种框的大小之前有着千丝万缕的联系,对检测性能的好坏影响程度大小不一。本篇文章基于自己在人脸检测方面的经验,说说对这些框之间关系的一些理解。
现在大部分人脸检测效果都已adaboost+LBP(各种改进)的方式实现,adaboost由N个强分类器组成,每个强分类器由M个弱分类器组成,而每个弱分类器其实就是一个特征。
本文以LBP特征为例,人脸检测共涉及到如下几类框:
1. LBP特征矩形框大小(极为重要)
2. 检测框大小(重要)
3. 检测目标大小(次要)
4. 原始训练样本大小(重要)
5. 图像大小(不重要)

<font size="3"><strong>前言</strong></font>
Batch Normalization是由google提出的一种训练优化方法。参考论文:Batch Normalization Accelerating Deep Network Training by Reducing Internal Covariate Shift
个人觉得BN层的作用是加快网络学习速率,论文中提及其它的优点都是这个优点的副产品。
网上对BN解释详细的不多,大多从原理上解释,没有说出实际使用的过程,这里从what, why, how三个角度去解释BN。
<font size="3" color="blue"><strong>1. 摘要</strong></font>
对于RNN解决了之前信息保存的问题,例如,对于阅读一篇文章,RNN网络可以借助前面提到的信息对当前的词进行判断和理解,这是传统的网络是不能做到的。但是,对于RNN网络存在长期依赖问题,比如看电影的时候,某些细节需要依赖很久以前的一些信息,而RNN网络并不能很好的保存很久之前的信息,随着时间间隔不断增大,RNN网络会丧失学习到很远的信息能力,也就是说记忆容量是有限的。例如,对于阅读一本书,从头到尾一字不漏的阅读,肯定是越远的东西忘得越多。所以引入了LSTM网络,对于LSTM来解决梯度消失梯度爆炸问题。
进入2018年,越来越多人开始习惯于让家里的亚马逊Alexa、谷歌助手之类的智能音响完成列购物清单、开灯、关灯之类的工作。相比于几年前已经进入普通人家、且如今看来已不再新鲜的扫地机器人来说,这些新兴的智能设备将加速促进生产生活和社会管理方式向智能化、精细化、网络化方向转变。
虽然我们越来越习惯于跟机器交谈,让其为我们完成一些琐碎的工作,但备受期待的物联网所带来的改变远不止于此,而是更加深远,是在一个充满智慧城市、互联程度越来越高的世界中机器与机器之间的互相联通。
<font size="3"><strong>集成学习(ensemble learning)</strong></font>
集成学习通过构建多个个体学习器,然后再用某种策略将他们结合起来,产生一个有较好效果的强学习器来完成任务。基本原理如下图所示。这里主要有三个关键点:个体学习器的同质异质、个体学习器的生成方式、结合策略。
<font size="3"><strong>背景</strong></font>
计算机视觉是利用摄像机和电脑代替人眼,使得计算机拥有类似于人类的对目标进行检测、识别、理解、跟踪、判别决策的功能。以美团业务为例,在商家上单、团单展示、消费评价等多个环节都会涉及计算机视觉的应用,包括文字识别、图片分类、目标检测和图像质量评价等方向。本文将通过以OCR(光学字符识别)的场景来介绍深度学习在计算机视觉中的应用。
<font size="3"><strong>基于深度学习的OCR</strong></font>
在经历成千上万个小时机器学习训练时间后,计算机并不是唯一学到很多东西的角色,作为开发者和训练者的我们也犯了很多错误,修复了许多错误,从而积累了很多经验。在本文中,作者基于自己的经验(主要基于 TensorFlow)提出了一些训练神经网络的建议,还结合了案例,可以说是过来人的实践技巧了。
作者| Matt H/Daniel R
译者| 婉清
编辑| Jane
出品| AI 科技大本营
<font size="3" color="blue"><strong>通用技巧</strong></font>
<font size="3"><strong> 1. 前言</strong></font>
传统的CNN网络只能给出图像的LABLE,但是在很多情况下需要对识别的物体进行分割实现end to end,然后FCN出现了,给物体分割提供了一个非常重要的解决思路,其核心就是卷积与反卷积,所以这里就详细解释卷积与反卷积。
Multi-Instance Learning (MIL) 和Multi-Pose Learning (MPL)是CV的大牛Boris Babenko at UC San Diego提出来的,其思想可以用下面一幅图概况。MIL是指一个对象的学习实例可能有很多种情况,学习的时候不是用一个精确的标注对象来学习,而是用一个对象的多个实例组成的“包”来学习;而MPL是指一个对象会有多个姿态(Pose),学习的时候用一个分类器常常难以达到很好的效果,所以可以训练多个分类器来分别学习不同的Pose。
<font size="3"><strong>1、图像语义分割的概念</strong></font>
<font color="#02c3b0"><strong>1.1图像语义分割的概念与原理</strong></font>
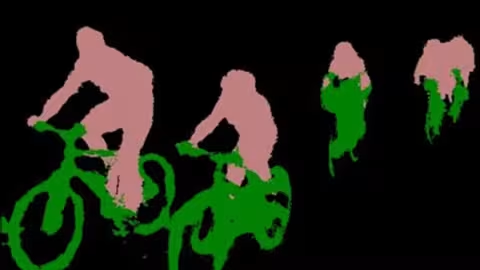
图像语义分割可以说是图像理解的基石性技术,在自动驾驶系统(具体为街景识别与理解)、无人机应用(着陆点判断)以及穿戴式设备应用中举足轻重。我们都知道,图像是由许多像素(Pixel)组成,而「语义分割」顾名思义就是将像素按照图像中表达语义含义的不同进行分组(Grouping)/分割(Segmentation)。
集成学习体现了“More is always better”(多多益善)的思想,它是是目前机器学习的一大热门方向,所谓集成学习简单理解就是指采用多个分类器对数据集进行预测,从而提高整体分类器的泛化能力。
<center><img src="http://imgtec.eetrend.com/sites/imgtec.eetrend.com/files/201809/blog/17…; alt="深入机器学习之集成学习"></center>

<strong>网络正则化</strong>
机器学习的核心问题是如何使学习算法不仅在训练样本上表现良好,而且在新数据上或测试集上同时奏效,学习算法在新数据上的这样一种表现我们称之为模型的泛化能力。如果一个学习算法在训练集表现优异,同时在测试集依然工作良好,可以说该学习算法有较强的泛化能力。若某算法在训练集表现优异,但是测试集却非常糟糕,我们说这样的学习并没有泛化能力,这种现象也叫做过拟合(overfitting)。
如何避免过拟合?我们可以使用正则化的技术来防止过拟合的情况。正则化是机器学习中通过显示的控制模型复杂度来避免模型过拟合,确保泛化能力的一种有效方式。