跳转到主要内容
成功案例:象帝先计算技术与Imagination合作——面向现代图形与计算工作负载的专业GPU
未来,象帝先计算技术计划将其GPU产品扩展到更广泛的专业图形与计算领域,覆盖桌面和服务器平台。Imagination将继续与象帝先计算技术及其他合作伙伴紧密合作,为专业显卡用户提供更多选择。
具身智能核心技术解析:三大技术路线构建虚实交互新范式

具身智能代表了人工智能发展的关键跃迁——从虚拟世界的符号推理迈向物理世界的具身交互。

Shader中的分支对性能的影响

在 GPU 中,线程是以 warp(通常是 32 个线程)为单位进行调度的。所有线程在同一个 warp 内执行相同的指令。

训练优化技术:混合精度训练(Mixed Precision Training)
混合精度训练是一种优化深度学习 训练过程的技术,通过结合使用不同精度的数据类型,在保证模型性能的同时,显著减少内存消耗,并加速训练过程。
AI算力爆发,数据中心正在消耗多少能源?

人工智能数据中心不仅带来了巨大的计算能力,同时也伴随着显著的能源消耗和环境压力。

实例化渲染技术GPU内部处理细节

在 OpenGL 中,实例化渲染技术允许开发者高效地绘制多个相同的几何体实例。

2026年最值得关注的语音识别AI应用

随着人工智能技术的不断进步,语音识别技术在近几年取得了显著发展。

RISC-V迎来关键拐点

RVA23 标志着主流 CPU 性能扩展方式的一个转折点。它强制要求使用 RISC-V 向量扩展 (RVV),从而将结构化、显式并行计算提升到与标量执行相同的架构地位。

训练优化技术:模型并行(Model Parallelism)

模型并行 是一种训练优化技术,旨在解决超大规模模型的训练问题。其核心思想是将模型的不同部分分配到不同的计算设备,以克服单个设备无法容纳大模型的问题。
智能网联汽车:HARA分析与ASIL等级评定

在汽车功能安全领域,遵循ISO 26262标准进行开发已成为行业共识。

专家洞察:功率而非面积:边缘GPU设计为何迎来新纪元

随着行业迈入2纳米以下制程,GPU设计正遭遇严峻的物理极限。

聊聊延迟着色并不支持抗锯齿的原因

虽然延迟着色在处理复杂场景和多光源时具有显著优势,但它在抗锯齿方面存在一些挑战。

量子时代来临:企业如何未雨绸缪

随着量子技术的快速发展,全球组织正面临计算能力的革命性跃升。

训练优化技术:数据并行(Data Parallelism)

数据并行(Data Parallelism) 是一种常见的训练优化技术,特别是在深度学习模型的训练过程中,用于提高训练效率和加速大规模模型的计算。

光纤连接:AI就绪数据中心的支柱

如今,密度、延迟和实时数据传输已成为现代数据中心设计成败的关键因素。

3D角色建模:何时使用模型资产更好,何时需要自行建模?

在CG与建筑可视化工作中,如何在创意构想与制作现实之间找到平衡,始终是一个核心课题。

中国信通院政经所联合发布《自动驾驶战略与政策观察(2025年)》

中国信通院政策与经济研究所刘杰对报告进行了深入解读。

TBDR架构下drawcall过多的致命隐患

TBDR架构下过多drawcall会导致Frame Data膨胀,引发内存压力、带宽拥堵、命令处理瓶颈和瓦片缓存溢出等问题,严重影响渲染性能。

训练优化技术:流水线并行(Pipeline Parallelism)
流水线并行(Pipeline Parallelism) 是一种优化技术,旨在加速大规模深度学习 模型的训练,尤其适用于模型 非常大,以至于无法直接在单个设备上训练的情况。
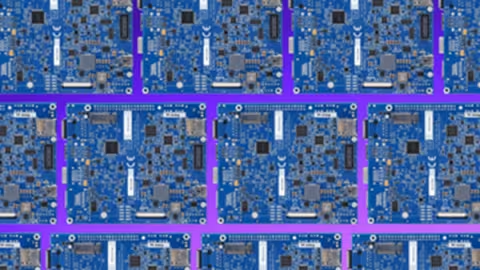
Imagination GPU 正式接入 Mesa CI

基于德州仪器(TI)AM68架构、搭载IMG BXS-4-64 GPU的设备集群现已集成至Mesa上游持续集成系统。